

ElevenLabs lance Eleven Realtime, des modèles speech-to-speech plus rapides et plus précis

Précision et vitesse ne sont plus incompatibles. C’est ce que veut prouver ElevenLabs, qui annonce ce mardi 20 octobre une nouvelle famille de modèles speech-to-speech. La start-up d’origine polonaise affirme avoir développé un modèle de conversation, Eleven Realtime v1, doté d’une grande précision dans ses réponses avec une latence minimale. Une nouvelle famille qui répond de façon plus humaine également (gestion des pauses, des interruptions et des tours de parole), permettant aux entreprises, sur le papier, de proposer des agents vocaux plus familiers.
La nouvelle famille supporte jusqu’à 90 langues et peut utiliser les 17 000 voix de la bibliothèque d’ElevenLabs.
Une famille de deux modèles
ElevenLabs annonce en réalité deux modèles différents :
- Eleven Realtime v1 Mini : pour les conversations en langage naturel simple où la latence est prioritaire. ElevenLabs le présente comme suffisant pour la majorité des cas d’usage.
- Eleven Realtime v1 Max : pour les tâches où le raisonnement et la précision comptent plus. Service client, workflows agentiques… Le modèle est idéal pour les cas d’usage qui demandent un raisonnement en plusieurs étapes (avec des outils par exemple).
Les deux modèles ont été entraînés pour être de véritables agents vocaux nativement. Jusqu’ici, il fallait utiliser plusieurs modèles chez ElevenLabs pour l’IA vocale (speech-to-text, LLM, text-to-speech…). C’est désormais une période révolue. La nouvelle famille englobe l’ensemble du process avec un vrai modèle de speech-to-speech.
Le Max devance le Mini, sauf sur la fluidité de la conversation
Scores des deux modèles Eleven Realtime v1, en %
Raisonnement vocalBig Bench Audio
Dynamique conversationnelleFull-Duplex-Bench
Tâches avec appels d’outilsTaux de réussite
Eleven Realtime v1 Max
Eleven Realtime v1 Mini
Source : ElevenLabs, évaluation indépendante d’Artificial Analysis, octobre 2026.
Dans les benchmarks, Eleven Realtime v1 Mini atteint 75,9% de précision en raisonnement vocal (capacité à répondre à des questions vocales, Big Bench Audio d’Artificial Analysis). Son grand frère, v1 Max, performe à 98,8%. Il passe devant Grok Voice 3.0 (98,5%) ou encore Gemini 3.8 Live Extended Thinking (97,7%), et frôle le plafond du benchmark. Sur la dynamique conversationnelle (sensation de parler à un humain), le Mini atteint 95,8%, un peu plus que le Max (94,1%), à un niveau similaire à GPT-Realtime 2.1 d’OpenAI. Sur les tâches qui demandent d’appeler des outils, l’écart se creuse : le Max en réussit 87,1%, contre 60,3% pour le Mini. Dans la Speech Agent Arena, où des utilisateurs comparent deux modèles à l’aveugle, le Max obtient 998 points et le Mini 988.
Enfin, côté latence, Eleven Realtime v1 Max répond en 470 millisecondes, et le Mini en 500. Pour comparaison, Grok Voice 3.0 répond en 810 millisecondes et GPT-Realtime-2 (High) en 1,14 seconde. Sur le papier, les performances sont donc excellentes au vu de la précision affichée.
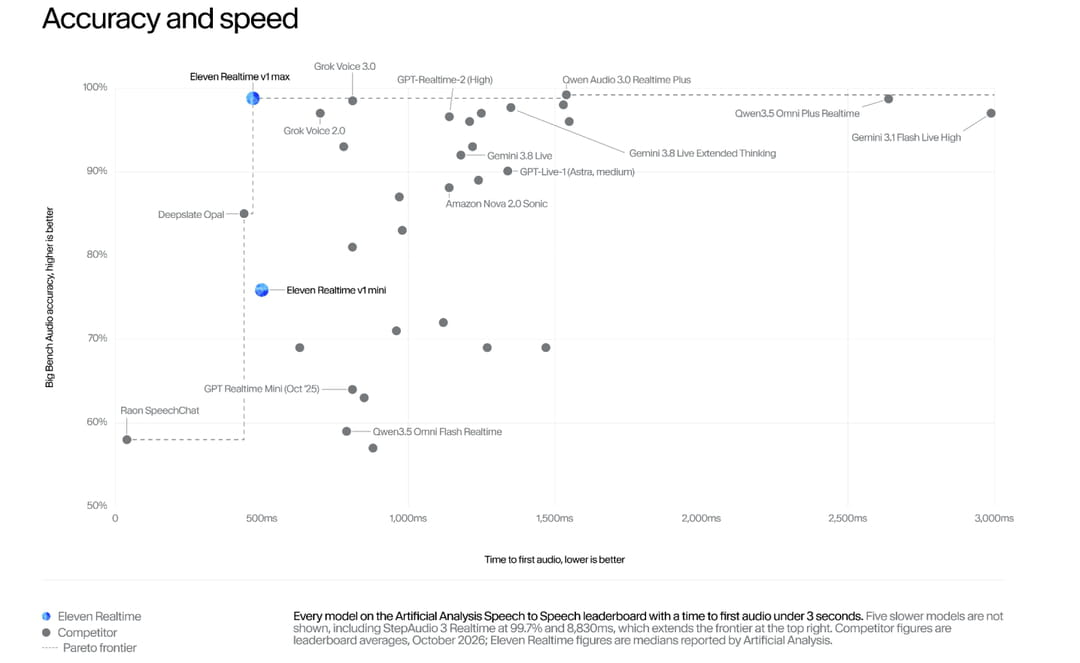
Sur le graphique d’Artificial Analysis, aucun modèle n’est à la fois plus précis et plus rapide que le Max : il offre le meilleur compromis entre précision et latence.
Une API compatible OpenAI
La famille est lancée dès aujourd’hui sur ElevenLabs avec un accès dans ElevenAgents (déploiement par téléphone, web, WhatsApp ou plateformes de centre de contact), et via la Realtime API de l’entreprise en WebSocket (le WebRTC n’est pas pris en charge au lancement). Cette dernière est entièrement compatible avec la Realtime API d’OpenAI : pour migrer un workflow agentique vocal d’OpenAI vers ElevenLabs, il suffit de changer l’endpoint (l’adresse d’appel de l’API) et le nom du modèle, et le SDK d’OpenAI fonctionne tel quel.
Côté prix, ElevenLabs indique que, dans ElevenAgents, les modèles Realtime suivent la tarification standard à la minute : le sélecteur de modèle affiche une estimation du coût par minute. Via la Realtime API, l’entreprise facture la minute d’audio connecté, plus les tokens, dont le prix reste le même quelle que soit la formule. Le prix au token, lui, n’a pas encore été communiqué à l'heure d'écrire ces lignes.
Avec une présence renforcée de jour en jour dans les grands groupes européens (Deutsche Telekom, Revolut, Klarna), cette nouvelle sortie assure à ElevenLabs un vrai potentiel de croissance. Disposer d’une famille de modèles à la fois précis et rapides permet aux entreprises d’envisager des cas d’usage réels en production d’agents vocaux : service client, assistance technique, tutorat, conseil à la vente, qualification de prospects… Les cas d’usage sont désormais limités uniquement par les possibilités créatives et le coût. Une vraie manne financière à aller chercher auprès des entreprises européennes legacy, qui ont encore du mal à passer aux agents vocaux, déjà largement déployés en production outre-Atlantique. Et ElevenLabs semble bien l’avoir compris. Les grandes organisations représentent désormais 55% de son chiffre d’affaires, contre 40% il y a douze mois.